― AIはどのように発展してきたのか ―
2-1 AI(Artificial Intelligence)の歴史と現在
― Transformer、ハルシネーション、AIリテラシー ―
2-2 Transformerの仕組み
― 言葉どうしの関係を学ぶニューラルネットワーク ―
2-3 Transformerの仕組みから理解する、生成AIが間違える理由
― もっともらしい答えが、事実とは限らない理由 ―
2-4 AI活用時に確認すべき四つの基本
― 安全に活用するために、人間が確認すべきこと ―
2-1 AI(Artificial Intelligence)の歴史と現在
― Transformer、ハルシネーション、AIリテラシー ―
第1部では、ICT、IT、IoT、DX、そして生成AIの発展にともない、仕事や職種のあり方がどのように変化してきたのかを整理しました。
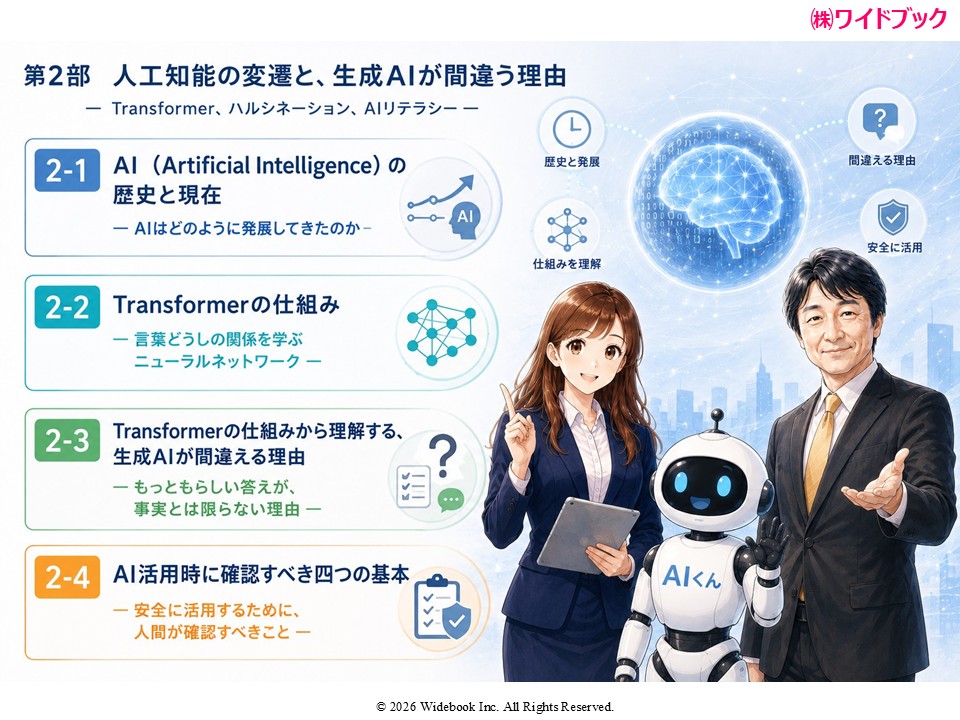
第2部では、AIがどのように発展して現在の生成AIにつながったのか、その基本的な仕組みと限界、そして安全に活用するために必要な考え方を学びます。
ここで大切なのは、AIの専門的な研究史や細かな年代を詳しく覚えることではありません。AIがどのような考え方から生まれ、どのように発展し、現在の生成AI(Generative AI)につながってきたのかを、大きな流れとして理解することです。
現在、私たちが日常的に活用し始めているChatGPTなどの生成AIは、文章、画像、音声、動画、プログラムなどを生み出し、人間の知的作業を支援する道具として急速に広がっています。
第2部では、次の四つの視点からシンプルに整理していきます。
・AIはどのように生まれ、発展してきたのか
・Transformerは、どのような仕組みなのか
・なぜ生成AIは、もっともらしい間違いを生み出すことがあるのか
・生成AIを安全に活用するために、何を確認すべきか
(1)AIとは何か
― 人間の代わりに考えるのではなく、知的活動の範囲を広げる支援技術 ―
AI(Artificial Intelligence:人工知能)は、時代や研究者の立場によって意味が変化してきたため、一言で定義することは簡単ではありません。
しかし、本書ではAIを、次のように捉えます。
「人間が行ってきた知的活動の一部を、コンピュータによって支援しようとする技術」
AIが支援する知的活動には、次のようなものがあります。
・情報を集め、分類し、整理する
・将来を予測する
・判断のための材料を示す
・文章や画像を生成する
・人間と対話する
・問題解決の選択肢を提示する
AIの仕組みは、技術の発展とともに大きく変化してきました。
初期のAIは、人間があらかじめ与えたルールや知識に基づいて答えを出す仕組みでした。
一方、現在のAI、特に生成AIでは、コンピュータの性能向上と大量のデータの蓄積を背景に、多くのデータから特徴やパターンを学習する仕組みが中心になっています。
ChatGPTなどの生成AIは、人間の指示に応じて、文章作成、情報整理、アイデア出し、プログラム作成などを短時間で支援できます。
ただし、AIは人間の代わりに、すべてを考え、判断し、責任を負う存在ではありません。人間の知的活動を支援し、思考の範囲を広げ、判断や表現を助ける強力な道具として理解することが重要です。
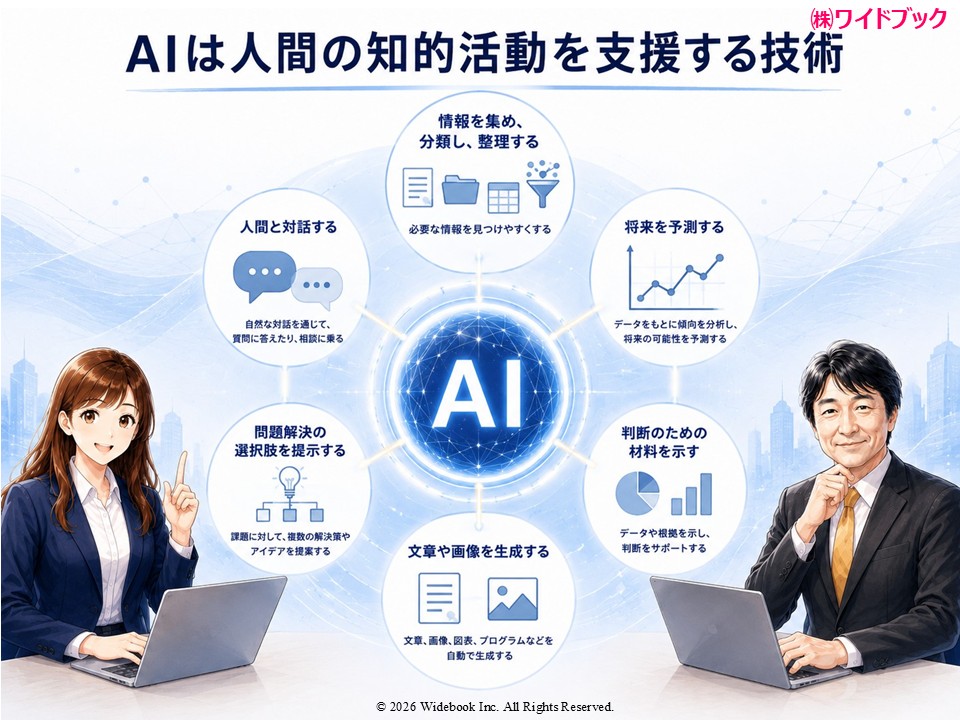
図2-1-1 AIは人間の知的活動を支援する技術
(2)AIの発展を大きな流れで見る
― 人間がルールを書く時代から、データから学習し、思考を支援する時代へ ―
① 1980年代:エキスパートシステムとルールの壁
AI研究は、1956年のダートマス会議を一つの出発点として、本格化しました。
その後、ビジネス分野でAIが大きく注目されるようになった代表的な技術が、1980年代のエキスパートシステム(Expert System)です。
エキスパートシステムとは、専門家が持っている知識や判断ルールを、人間があらかじめコンピュータへ登録し、そのルールに基づいて判断させる仕組みです。
たとえば、
「もし売上が一定水準を下回り、在庫が多いなら、値引きを検討する」
というようなルールを数多く登録し、条件に応じてコンピュータに判断させます。
このように、専門家の知識を形式化し、組織で活用するという考え方は、その後のナレッジマネジメントにも通じるものがあります。
しかし、現実の仕事では、すべての判断をルールとして書き出すことは簡単ではありません。
例外も多く、環境や条件が変わるたびに、ルールを追加したり修正したりする必要があります。
そのため、エキスパートシステムには、複雑で変化の大きい現場に対応し続けることに難しさがありました。
こうした「人間がすべてのルールを書く」ことの限界も、やがてデータから特徴やパターンを学習するAIが発展していく背景の一つとなりました。
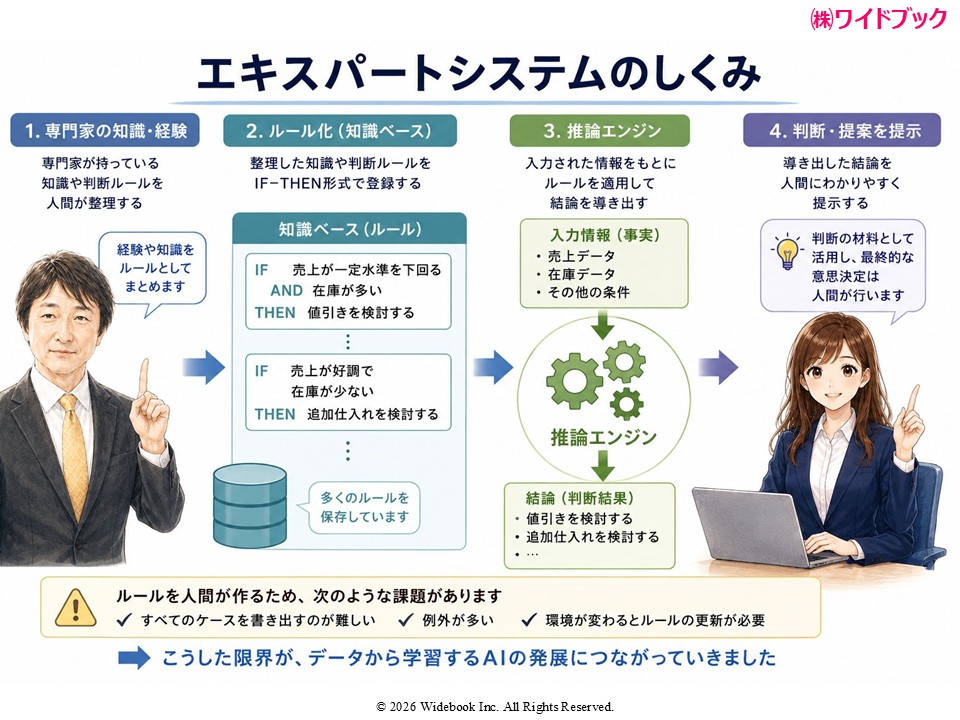
図2-1-2 エキスパートシステムのしくみ
② 1990年代:ニューラルネットワークの実用化と課題
1990年代に入ると、人間の脳の神経回路を参考にしたニューラルネットワークを活用し、株価予測、需要予測、品質管理など、さまざまな分野への応用が試みられるようになりました。
ニューラルネットワークは、人間が細かなルールを一つずつ書くのではなく、データからパターンや関係を学習し、予測や分類などに活用する技術です。
しかし当時は、現在ほど大量のデータを収集・蓄積・処理する環境が整っていませんでした。また、コンピュータの計算能力にも限界があり、大規模で複雑なニューラルネットワークを扱うことは容易ではありませんでした。
さらに、ニューラルネットワークが「なぜその答えを導き出したのか」という過程を、人間が論理的に説明しにくいという課題もありました。
そのため、この時期のニューラルネットワークの活用は一部の分野にとどまり、現在のような本格的な普及には至りませんでした。
その後、インターネットの普及によるデータ量の増大と、コンピュータの計算能力の向上によって、AIを取り巻く環境は大きく変化していきます。
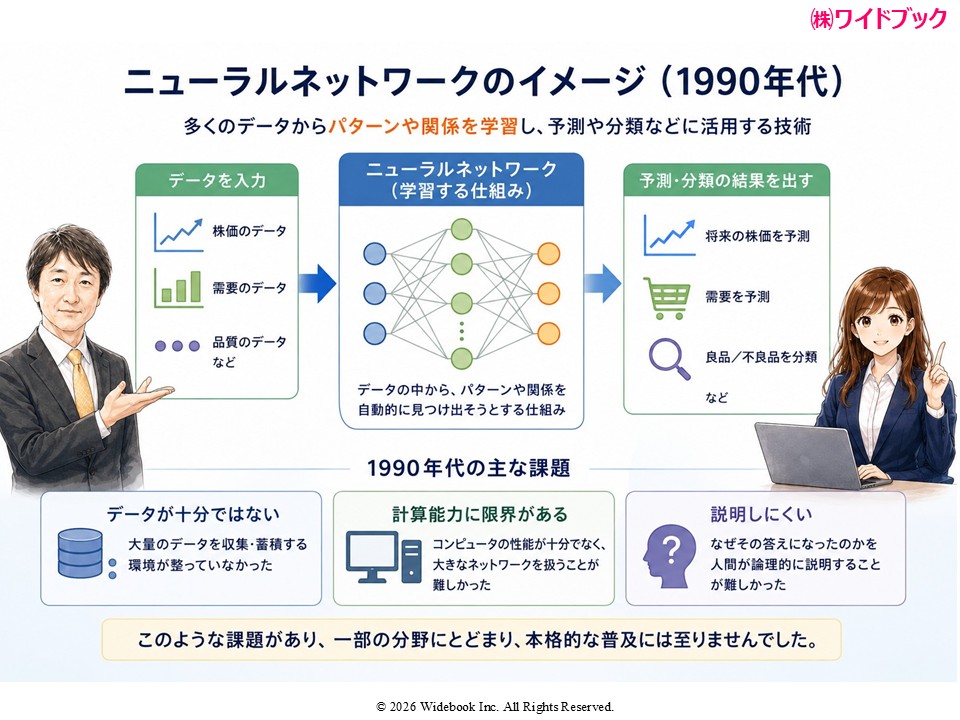
図2-1-3 1990年代におけるニューラルネットワークの実用化
③ 2010年代:ディープラーニングによる大きな進化
大きな転機となったのが、2012年ごろから急速に発展したディープラーニング(Deep Learning:深層学習)です。
インターネットの普及により、大量のデータが蓄積されました。加えて、GPUをはじめとするコンピュータの計算能力も飛躍的に向上しました。
こうした条件が重なり、AIは特に画像認識の分野で大きな成果を上げるようになりました。
AIは、「人間が細かなルールを書き込むもの」から、「大量のデータから特徴を学習し、高い精度で認識・予測するもの」へと大きく進化しました。
この技術は、画像認識だけでなく、音声認識、翻訳、自然言語処理など、多くの分野へ広がっていきました。
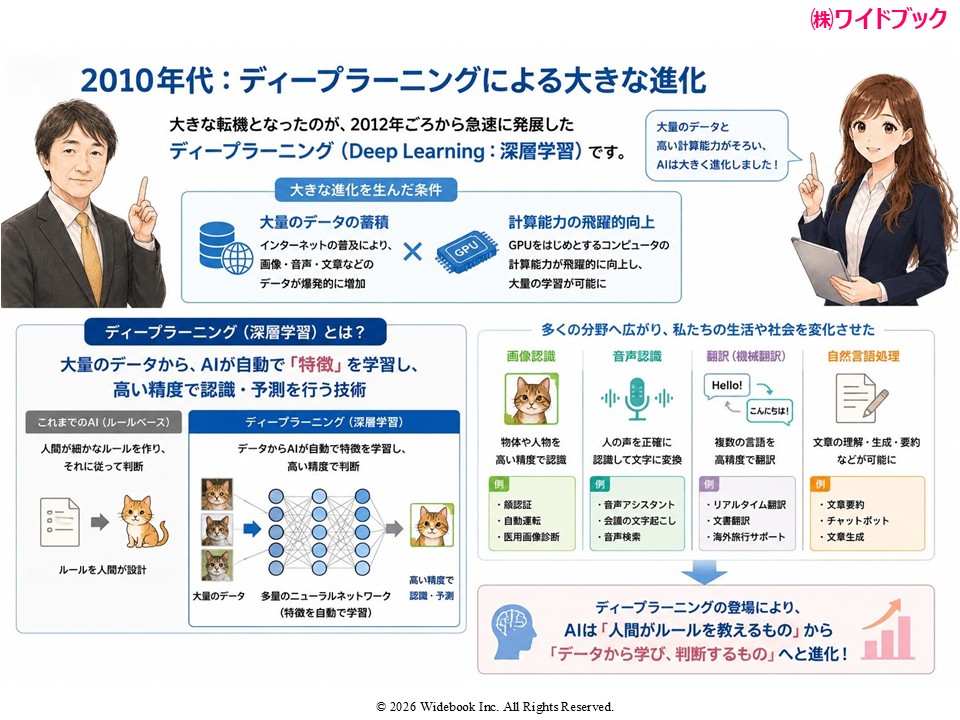
図2-1-4 ディープラーニングによるAIの大きな進化
④ 2017年以降:TransformerからChatGPT、そして生成AIへ
2017年に提案されたTransformerという技術は、大量の文章データを効率よく処理し、言葉どうしの関係や文脈を捉える能力を大きく高めました。
この技術は、大規模言語モデル(LLM:Large Language Model)の発展につながります。
そして、2022年にChatGPTが公開されたことで、生成AIは研究者や技術者だけのものではなく、多くの人が日常的に使える道具として急速に広がりました。
現在の生成AIは、文章を作成するだけではありません。
・情報を要約し、構造化する
・アイデアを広げる
・企画のたたき台を作る
・プログラム作成を支援する
・画像、音声、動画を作る
・学習や仕事の対話相手になる
このように、生成AIは人間の知的活動を広く、深く支援する方向へ進化を続けています。
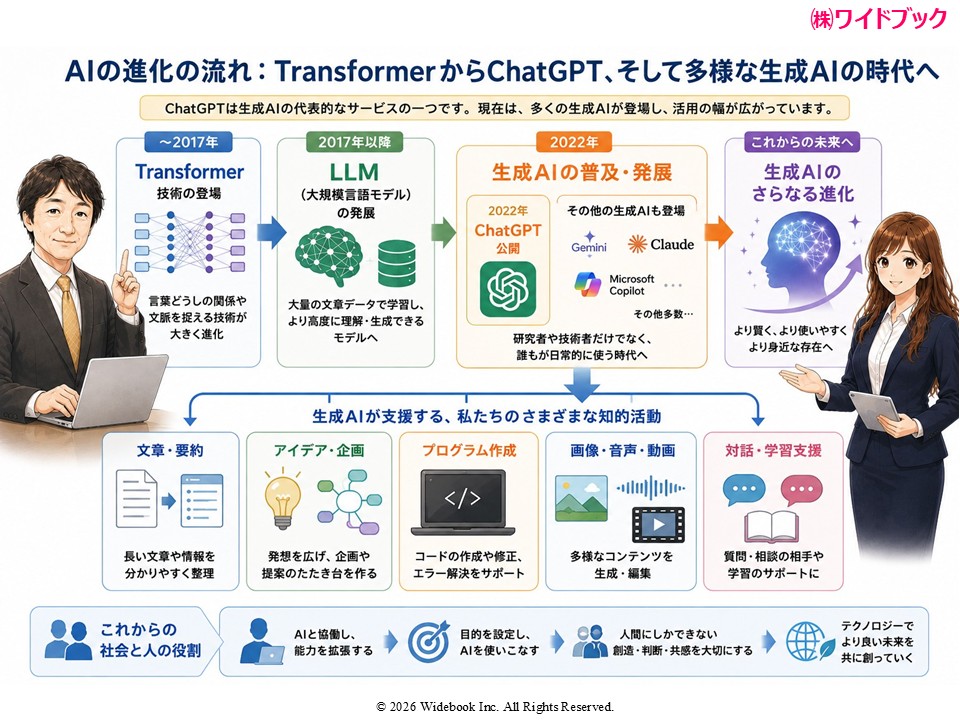
図2-1-5 TransformerからChatGPTへ ― 生成AIの進化と活用
本節のまとめ
― AIの発展から、現在の生成AIを捉える ―
AIは、ある日突然、現在の生成AIになったわけではありません。
人間が知識やルールを与える仕組みから、データから特徴を学ぶ機械学習、ニューラルネットワーク、ディープラーニングへと発展し、さらに大量の文章を学習して自然な文章を生成できる生成AIへと進化してきました。
こうした発展によって、AIは単に決められた処理を自動化するだけでなく、情報を整理・要約したり、文章や画像を作ったり、アイデアを示したり、人間との対話を通じて思考を支援したりする技術へと広がっています。
一方で、生成AIを正しく活用するためには、「何ができるか」だけでなく、「どのような仕組みで答えを作っているのか」を理解することも重要です。
次の節では、現在の生成AIを支える重要な技術の一つであるTransformerについて、その基本的な仕組みを見ていきます。
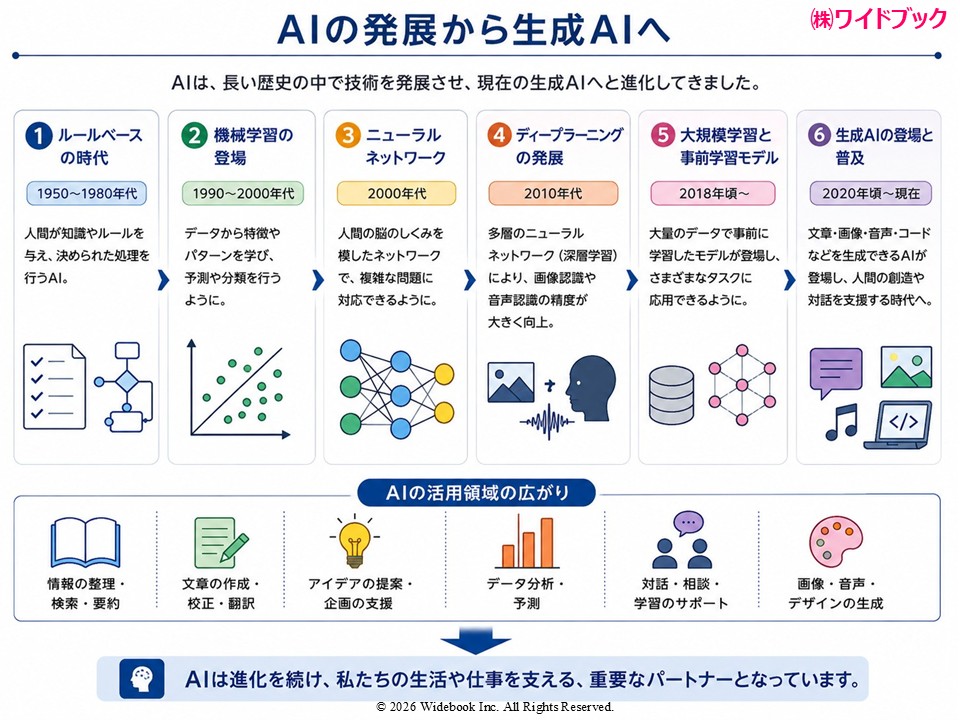
図2-1-6 AIの発展から生成AIへ
2-2 Transformerの仕組み
― 言葉どうしの関係を学ぶニューラルネットワーク ―
ChatGPTなどの生成AIは、文章をどのように処理し、次に続く言葉を作っているのでしょうか。
その中心にあるのが、Transformer(トランスフォーマー)と呼ばれるニューラルネットワークの構造です。
画像認識では、近くにある画素の色や形を手がかりにして、線、目、耳、輪郭などの特徴を段階的に学びます。
一方、文章では、近くにある言葉だけを見るのでは十分ではありません。主語、時間、場所、目的語など、離れた位置にある言葉どうしの関係を捉える必要があります。
Transformerは、そのために、文章中の言葉どうしの関係を計算する仕組みを持っています。
ここでいう「文脈を捉える」とは、AIが人間のように文章の意味を理解して、話題を分類しているという意味ではありません。
文章中のそれぞれの言葉が、周囲のどの言葉とどの程度関係しているかを計算し、その関係を反映した情報として表現することを、本書では「文脈を捉える」と表現しています。
それでは、図に沿って基本の流れを確認しましょう。
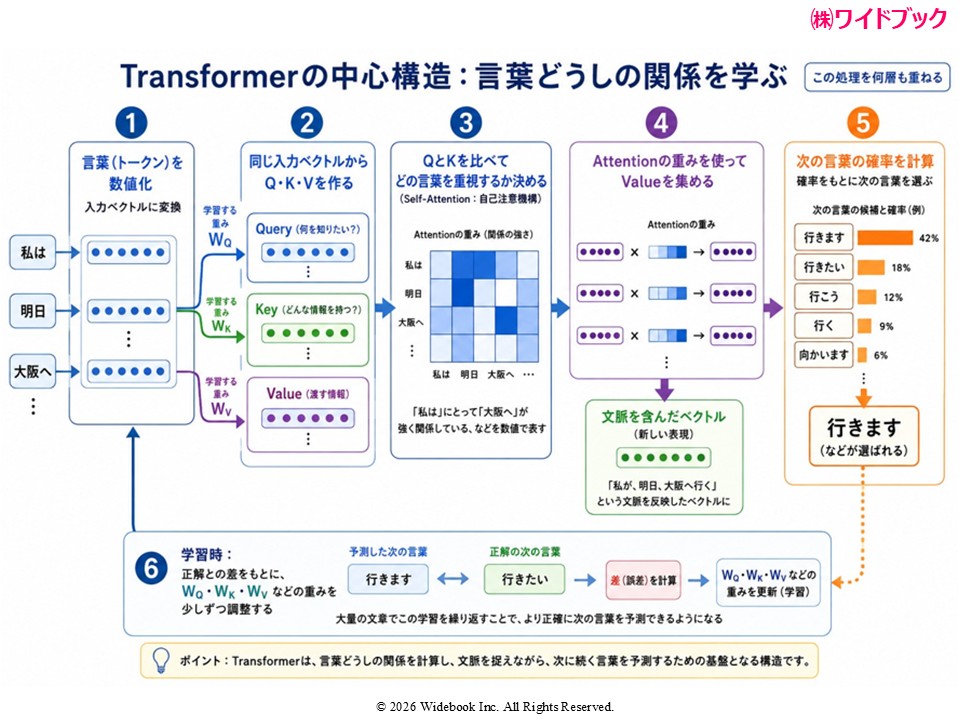
図2-2-1 Transformerの中心構造:言葉どうしの関係を学ぶ
① 言葉を入力ベクトルに変える
まず、AIは文章を「トークン」と呼ばれる処理単位に分け、それぞれを数値のまとまりに変換します。
本書では、仕組みを分かりやすく説明するため、以降はこの処理単位を「言葉」として説明します。
たとえば、「私は」「明日」「大阪へ」といった言葉は、そのまま処理されるのではなく、数値のまとまりに変換されます。
この数値のまとまりを、入力ベクトルといいます。言葉の意味や使われ方は、この多数の数値の組によって表されます。 AIは文章を文字のまま読んでいるのではなく、数値として処理しています。
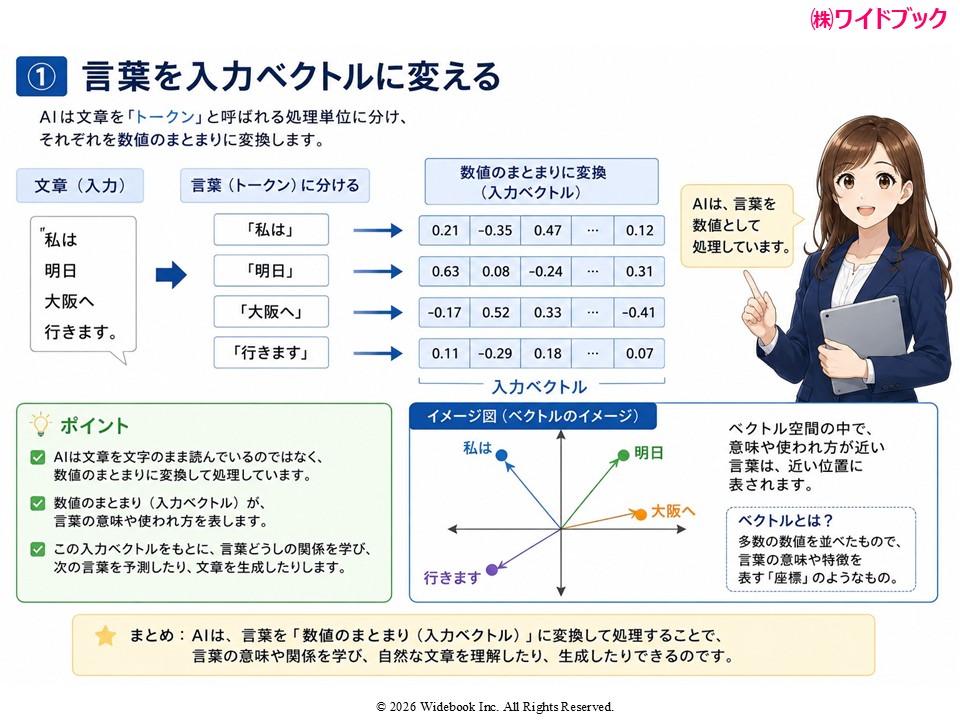
図2-2-2 言葉を数値に変換する ― トークンから入力ベクトルへ ―
② 同じ入力ベクトルから、Query・Key・Valueを作る
Transformerでは、同じ入力ベクトルに対して、三種類の異なる学習用の重みを掛けます。
一つ目は、Queryです。
Queryは、その言葉が、ほかの言葉のどの情報に注目するかを計算するための数値です。
二つ目は、Keyです。
Keyは、それぞれの言葉が、Queryとどの程度関係しているかを計算するための数値です。
三つ目は、Valueです。
Valueは、その言葉が持つ情報のうち、関係の強さに応じて取り出す情報を表す数値です。
Query、Key、Valueは、人間が一つずつ設定するものではありません。入力ベクトルに、学習によって調整される異なる重みを掛けることで作られます。
QueryとKeyを比べて言葉どうしの関係の強さを計算し、その強さに応じてValueの情報を集めます。
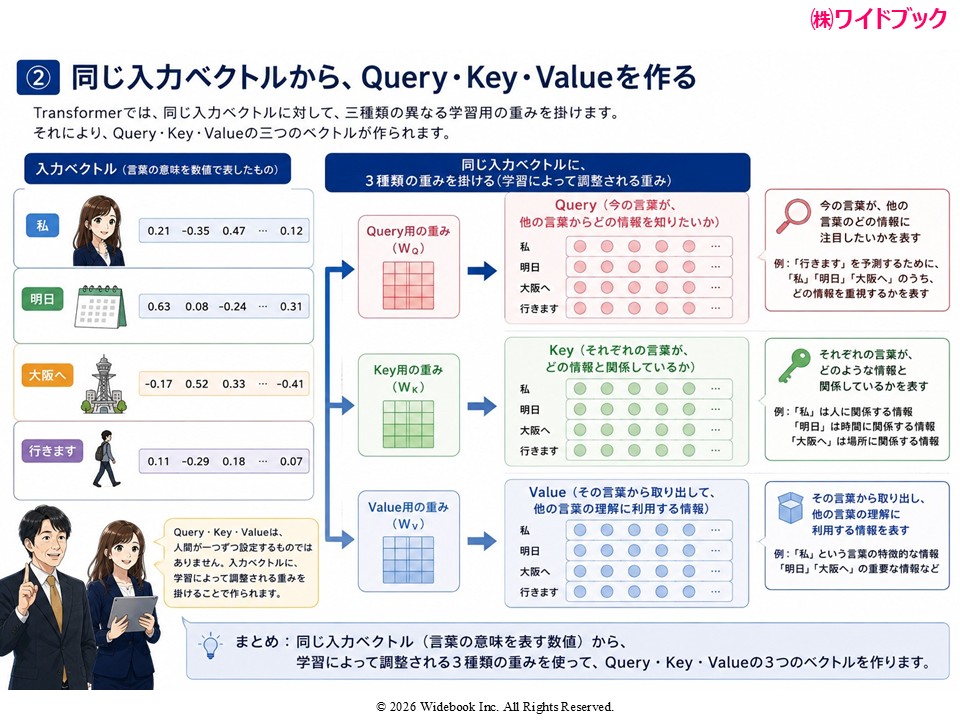
図2-2-3 同じ入力ベクトルからQuery・Key・Valueを作る
③ QueryとKeyを比べ、どの言葉を重視するかを決める
次に、AIはQueryとKeyを比べます。
この計算によって、文章の中のどの言葉とどの言葉が、どの程度強く関係しているかを数値で求めます。
たとえば、「私は」「明日」「大阪へ」という言葉がある場合、それぞれの言葉が、ほかの言葉とどの程度関係しているかを計算します。
このように、同じ文章の中にある言葉どうしの関係の強さを計算する仕組みを、Self-Attention(自己注意機構)といいます。
その計算結果が、Attentionの重みです。
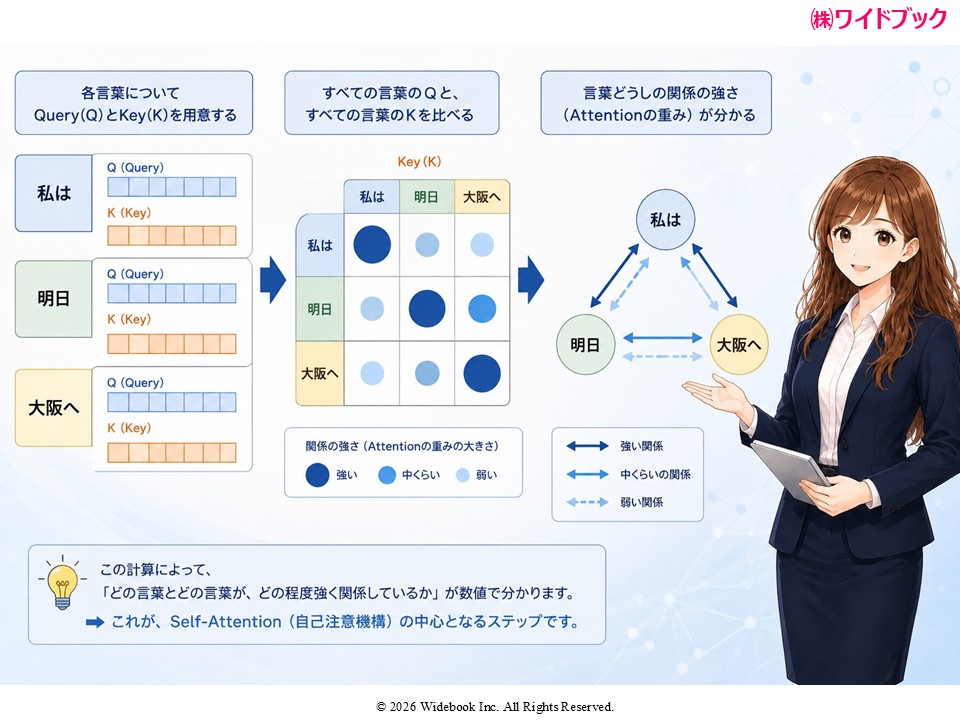
図2-2-4 QueryとKeyを比べ、どの言葉を重視するかを決める
④ Attentionの重みを使って、Valueを集める
次に、Attentionの重みを使って、各言葉が持つValueの情報を集めます。
関係が深い言葉の情報は多く取り込み、関係が弱い言葉の情報は少なく取り込みます。
その結果、「私は」「明日」「大阪へ」など、それぞれの言葉の表現に、周囲の言葉との関係が反映されます。
このように、言葉を単独で扱うのではなく、周囲の言葉との関係を反映した情報へ変えていくことが、Transformerが文脈を捉える基本となります。
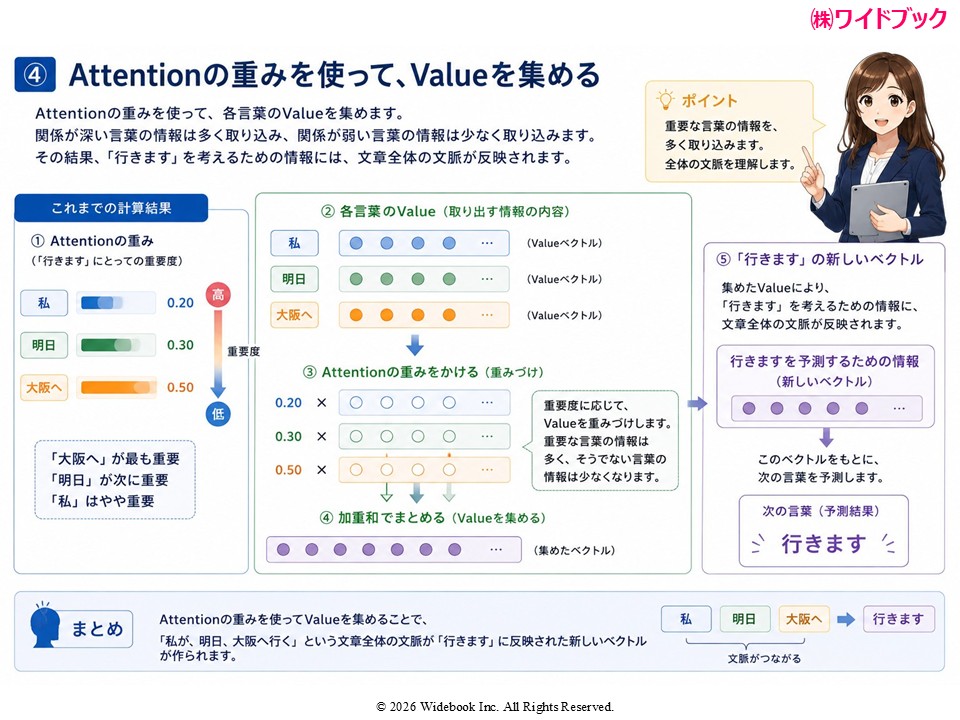
図2-2-5 Attentionの重みを使って、Valueを集める
⑤ 次に続く言葉の確率を出す
周囲の言葉との関係を反映したベクトルをもとに、AIは次に続く言葉の候補と、それぞれの確率を計算します。
たとえば、「行きます」「行きたい」「行こう」など、次に続く候補それぞれの確率を計算し、その確率をもとに次の言葉を選びます。選ばれた言葉を文章に加え、今度はその文章をもとに、さらに次の言葉を予測します。この処理を一語ずつ繰り返すことで、生成AIは文章を作っていきます。
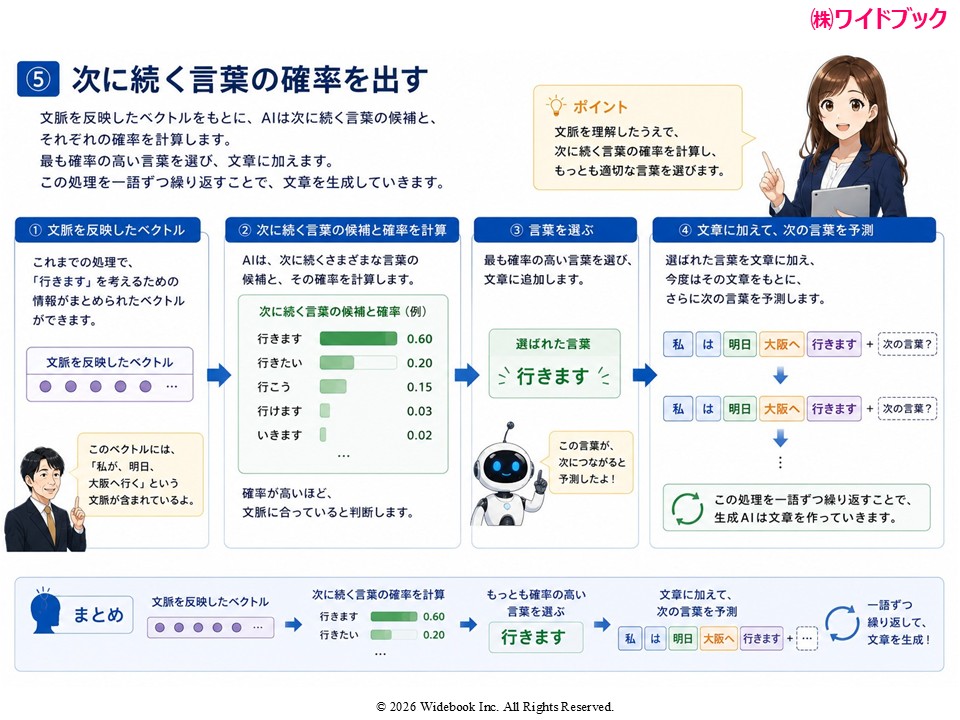
図2-2-6 次に続く言葉の確率を出す
⑥ 正解との差をもとに、内部の重みを学習する
学習の段階では、AIが予測した次の言葉と、学習用文章に実際に書かれている次の言葉を比べます。
予測が正解から外れていれば、その差をもとに、Queryを作るための重み W_Q、Keyを作るための重み W_K、Valueを作るための重み W_Vをはじめとする、ネットワーク内部の重みを少しずつ調整します。
この学習を、大量の文章に対して何度も繰り返します。
さらに、図にある一連の処理を何層も重ねることで、AIは単純な言葉のつながりだけでなく、文節、文章、段落などの、より複雑な関係を捉えられるようになります。
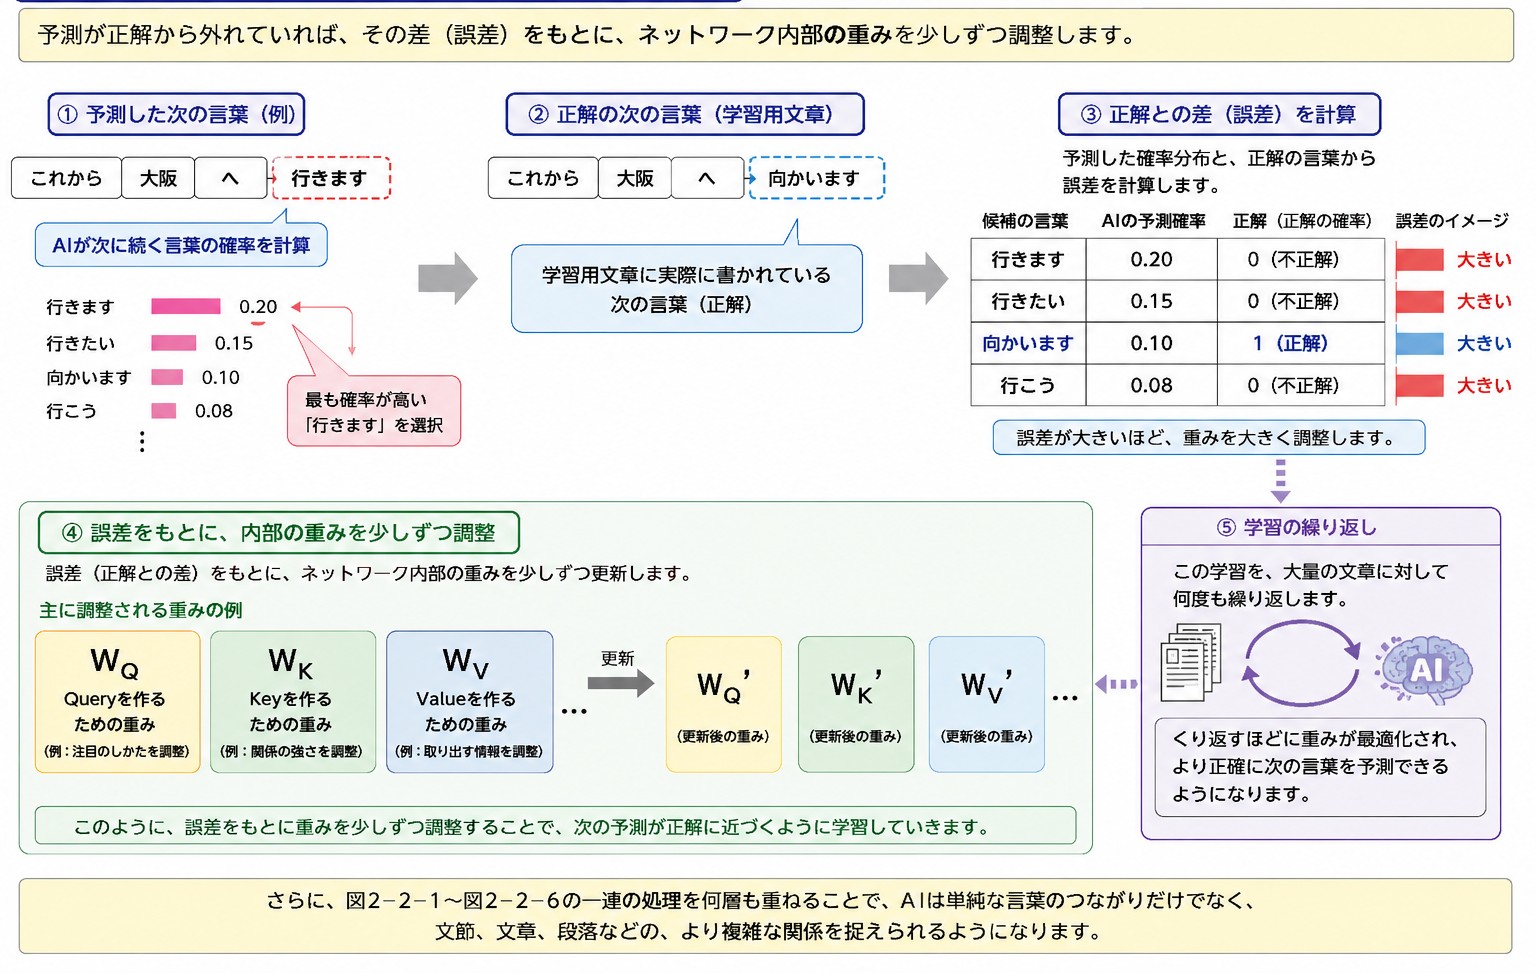
図2-2-7 正解との差をもとに、内部の重みを学習する
■ Transformerの仕組みをまとめる
Transformerとは、このように、言葉どうしの関係を計算し、周囲の言葉との関係を反映しながら、次に続く言葉を予測するための基盤となるニューラルネットワークの構造です。
Transformerの仕組みを基盤として、大量の文章データと多数のパラメータを用いて学習した大規模なモデルが、大規模言語モデル(LLM:Large Language Model)です。
実際のTransformerには、本書で説明したSelf-Attentionだけでなく、複数の視点から言葉どうしの関係を捉えるMulti-Head Attention、言葉の位置や順序を扱う仕組み、各言葉の情報をさらに変換するFeed Forward Network、計算を安定させるLayer Normalizationなど、複数の仕組みが組み合わされています。
本書では、初学者がTransformerの基本的な考え方を理解できるように、その中心となるSelf-Attentionの流れに絞って説明しています。

図2-2-8 Transformerの仕組み(まとめ)
本節のまとめ
― Transformerは、言葉どうしの関係から文脈を捉える ―
Transformerは、文章中の言葉を数値として処理し、言葉どうしの関係を計算することで、周囲の言葉との関係を反映した情報を作るニューラルネットワークの構造です。
まず、文章をトークンと呼ばれる処理単位に分け、それぞれを入力ベクトルという数値のまとまりに変換します。
次に、その入力ベクトルからQuery・Key・Valueを作り、QueryとKeyを比較することで、文章の中のどの言葉をどの程度重視するかを計算します。この仕組みがSelf-Attention(自己注意機構)です。
そして、Attentionの重みを使ってValueの情報を集めることで、周囲の言葉との関係を反映した新しいベクトルを作ります。
この情報をもとに、AIは次に続く言葉の候補と確率を計算し、その確率をもとに言葉を選びます。この処理を繰り返すことで、文章を生成していきます。
学習の段階では、予測した言葉と学習用文章の正解との差をもとに、ネットワーク内部の重みを少しずつ調整します。大量の文章を使ってこの学習を繰り返すことで、より複雑な言葉どうしの関係を捉えられるようになります。
重要なのは、生成AIが文章を作る基本には、「それまでの言葉との関係をもとに、次に続く言葉を予測する」という仕組みがあることです。
この仕組みによって、生成AIは自然で分かりやすい文章を作ることができます。
しかし、文章の流れに合う言葉を予測することと、その内容が事実として正しいことを確認することは同じではありません。
次の節では、このTransformerの仕組みを手がかりに、なぜ生成AIがもっともらしい誤った答えを作ることがあるのかを見ていきます。
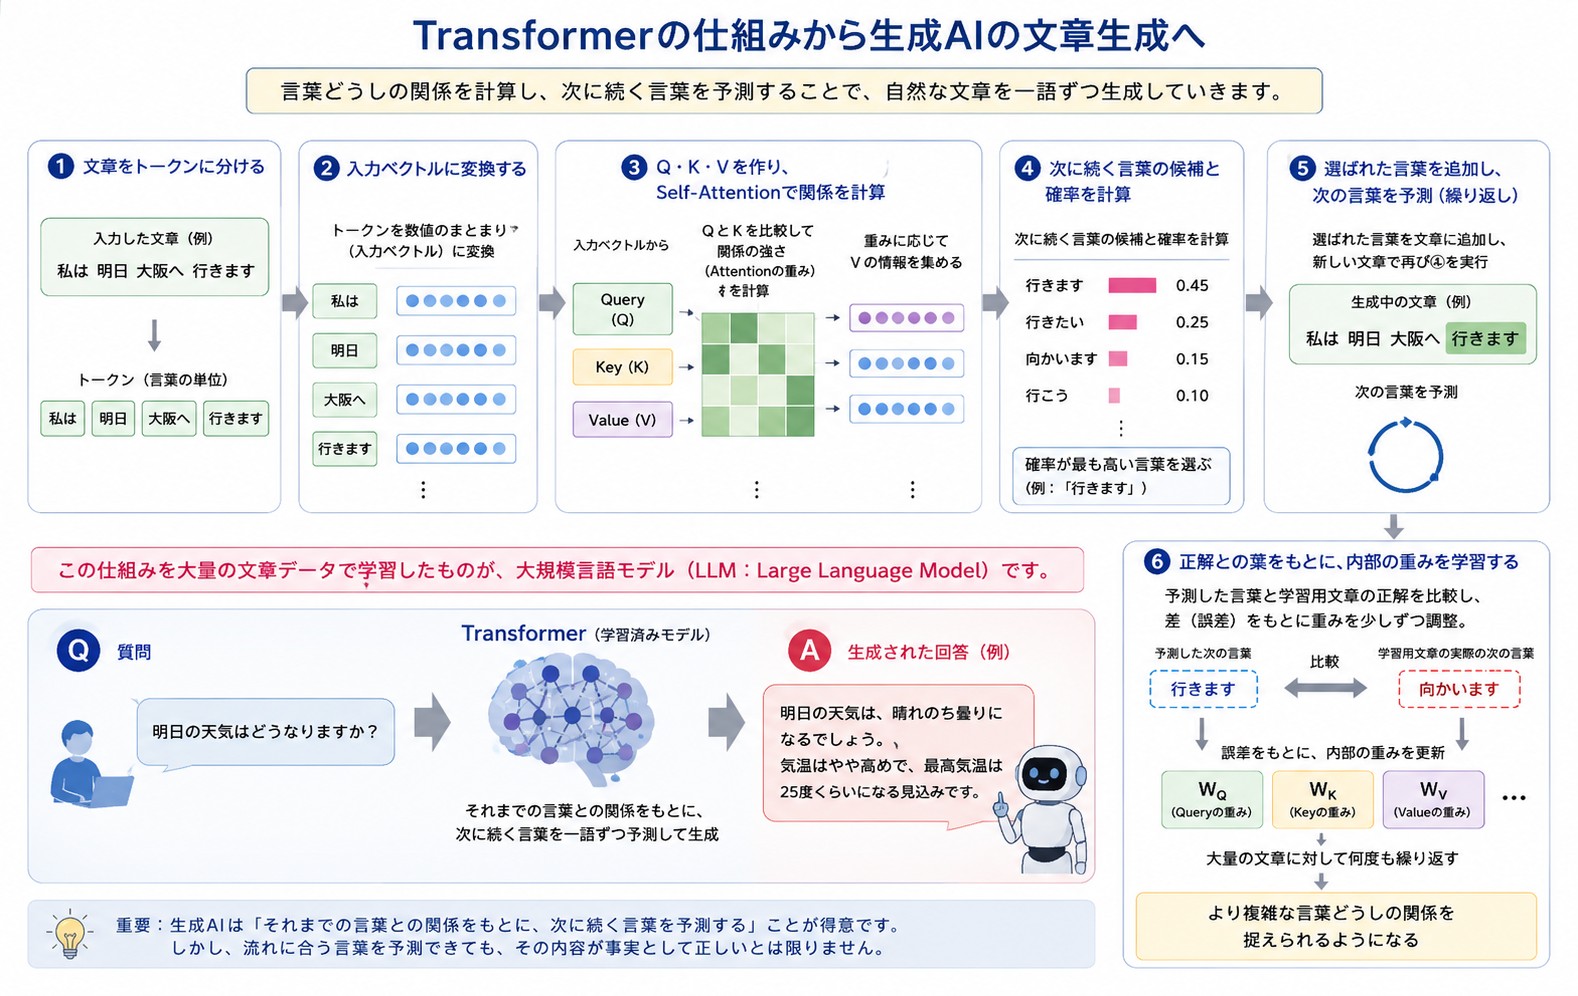
図2-2-9 Transformerの仕組みから生成AIの文章生成へ
2-3 Transformerの仕組みから理解する、生成AIが間違える理由
― もっともらしい答えが、事実とは限らない理由 ―
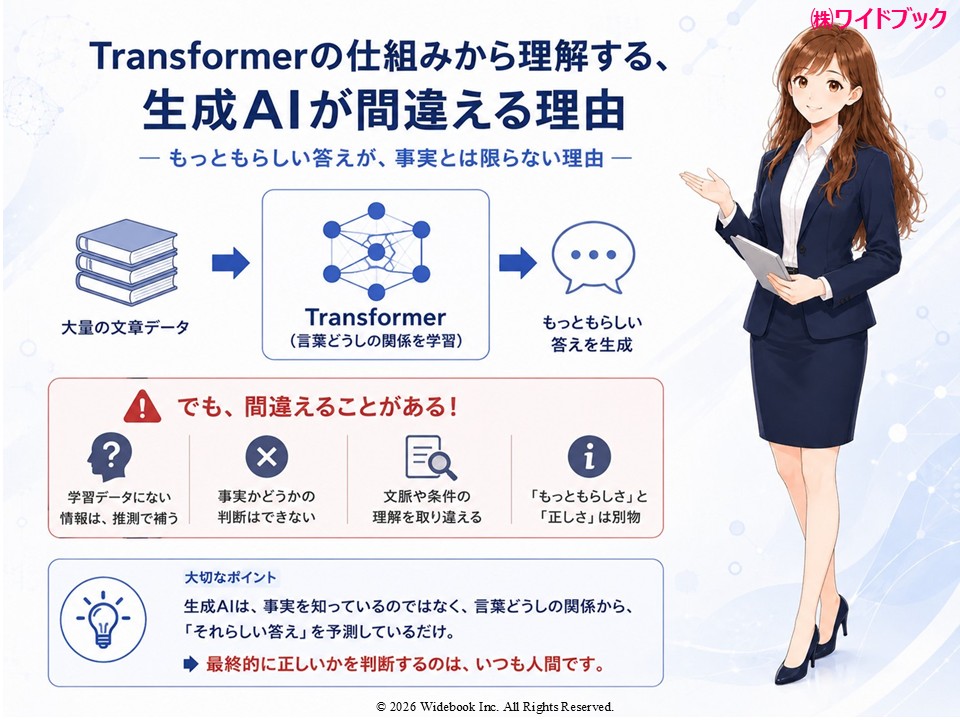
前の節では、Transformerが文章中の言葉どうしの関係を計算し、次に続く言葉の確率を求め、その確率をもとに言葉を選びながら文章を作る仕組みを確認しました。
この仕組みによって、生成AIは自然な文章を作り、情報を整理し、説明や企画のたたき台を短時間で示すことができます。
しかし、ここで注意しなければならないことがあります。
生成AIは、人間のように事実を一つひとつ確認してから答えているわけではありません。また、検索機能などを利用しない場合、常に外部の信頼できる資料を確認してから回答しているわけでもありません。
生成AIは、質問の文脈や学習した文章のパターンなどをもとに、次に続く言葉を予測しながら文章を作っています。
つまり、文章として自然な言葉を予測することと、その内容が事実として正しいことを確認することは、同じではありません。
そのため、生成された文章が自然で説得力のある内容に見えても、事実とは異なる情報が含まれることがあります。
特に、情報が不足している場合、情報が古い場合、あるいは質問そのものに誤った前提が含まれている場合には、注意が必要です。
たとえば、AIに次のように尋ねたとします。
「A社の最新の売上高、代表者名、主力事業を調べ、紹介文を作ってください。」
AIは、次のような整った文章を出力するかもしれません。
「A社は2024年度に売上高1,200億円を達成し、山田氏が代表を務める、クラウド事業を主力とする企業です。」
しかし、この文章には、次のような誤りが含まれている可能性があります。
・社名が似た別会社の情報と混同されている
・古い年度の数値が、最新情報のように示されている
・実在しない人物名や数値が補われている
・事実ではない事業内容が、文章の流れに合わせて加えられている
AIは、わざと誤った情報を出しているわけではありません。
企業紹介文として自然に見える文章になるように、学習した言葉のパターンや質問の文脈をもとに文章を生成した結果として、誤った情報が含まれることがあります。
また、一度誤った情報が会話の中に入ると、その後の対話にも影響することがあります。
たとえば、誤った会社名や売上高を含む回答に対して、
「その理由を詳しく説明してください」
「根拠を追加してください」
と問い続けると、AIは、その誤った情報も会話の文脈の一部として受け取ります。
その結果、最初の誤りを前提として、さらにもっともらしい説明を作ってしまうことがあります。
生成AIにとって、「もっともらしい文章」と「事実として正しい情報」は同じではありません。
そのため、AIの回答をそのまま事実として受け取るのではなく、会社名、人物名、数値、法律、制度、年月日、最新情報などの重要な情報については、信頼できる情報源で確認することが必要です。
生成AIを安全に活用するためには、AIが何を得意とし、どのような場面で誤りが生じやすいのかを理解したうえで、人間が確認し、判断することが重要です。
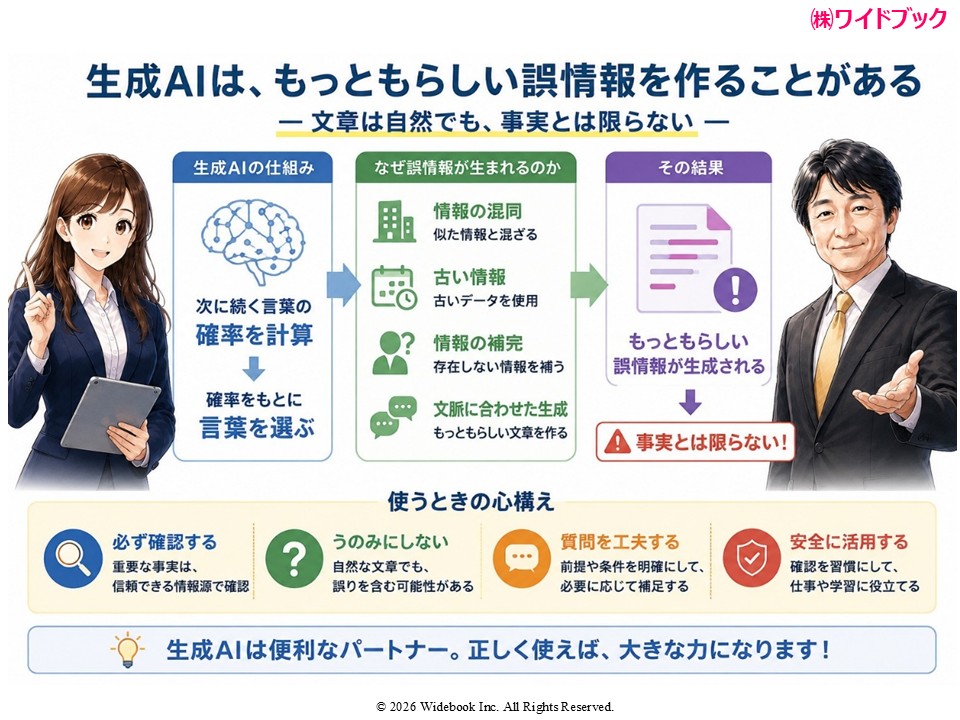
図2-3-1 生成AIはもっともらしい誤情報を作ることがある
(1)AIが誤った情報を出す四つの主なパターン
生成AIは、さまざまな理由から、事実とは異なる情報を示すことがあります。
なお、これらと似た誤りは、人間同士の会話でも起こることがあります。記憶が曖昧なまま話を補ったり、古い情報を現在のこととして話したり、相手の誤った前提に合わせて話を続けたり、話題の変化を取り違えたりすることは、人間にもあります。
生成AIの場合は、こうした誤りが自然で説得力のある文章として短時間に生成されるため、特に注意が必要です。
ここでは、AIが起こしやすい誤りを、次の四つのパターンに整理して見ていきます。
① ハルシネーション(幻覚)
生成AIは、質問に答えるための十分な情報や根拠がない場合でも、文脈に合う言葉を予測しながら文章を生成することがあります。
その結果、実在しない人物、書籍、法律、統計、出来事などを、あたかも事実であるかのように、もっともらしく示してしまうことがあります。
このように、事実とは異なる情報をもっともらしく生成する現象を、ハルシネーション(幻覚)といいます。
たとえば、実在を確認できない会社について売上高を尋ねたときに、AIが、
「2025年度の売上高は○○億円です」
と、根拠を確認できない数値を、事実であるかのように示してしまう場合があります。
文章が自然で説得力があっても、その内容が事実であるとは限りません。
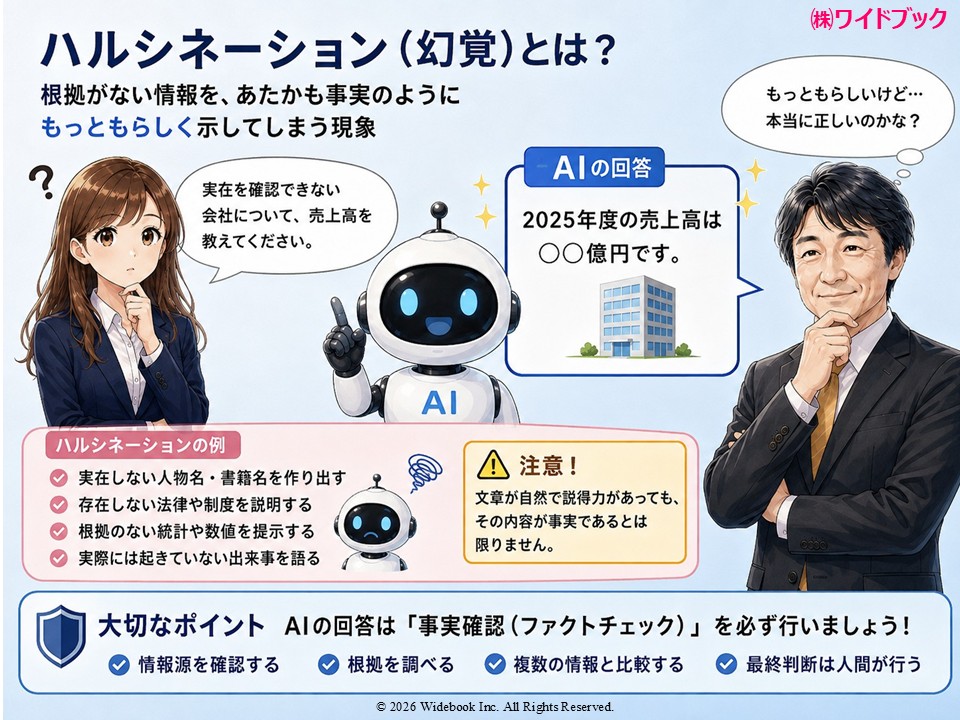
図2-3-2 ハルシネーション(幻覚)― もっともらしい誤情報に注意する ―
② 最新性や時点の取り違え
制度、法律、価格、役職、統計、ニュースなどについて、古い情報を新しい情報のように扱ったり、情報の時点を取り違えたりすることがあります。
これらの情報は時間とともに変化するため、内容そのものが正しくても、時点が違えば現在は正しくない場合があります。
たとえば、以前の制度や料金、過去の役職者、古い統計データなどが、現在も有効であるかのように示されることがあります。
そのため、最新性が重要な情報については、AIの回答だけで判断せず、「いつの情報なのか」を確認し、必要に応じて公式情報や最新の資料で確かめることが重要です。
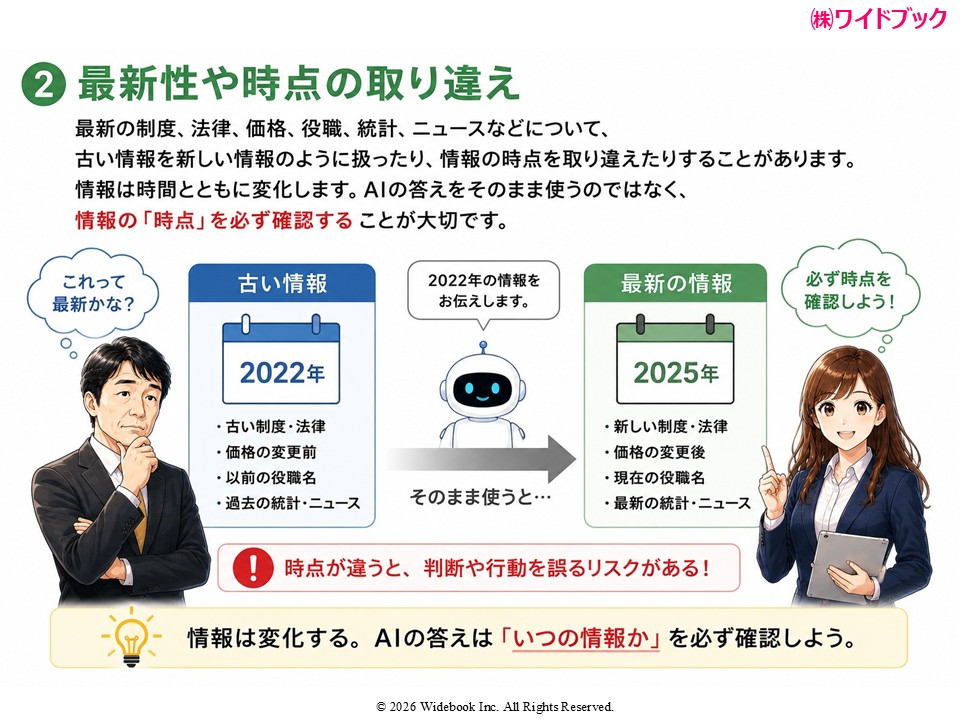
図2-3-3 AIは情報の最新性や時点を取り違えることがある
③ 誤った前提への同調
利用者が誤った前提で質問したときに、AIがその誤りを十分に指摘せず、前提に合わせて説明を続けてしまうことがあります。
生成AIは、質問の内容や、それまでの会話の流れを文脈として受け取り、その文脈に合う回答を作ろうとします。そのため、質問の中に誤った事実や思い込みが含まれていると、それを正しい前提として受け取り、もっともらしい説明を作ってしまう場合があります。
たとえば、誤った制度名や会社情報、事実ではない出来事などを前提として質問すると、その誤りを十分に指摘せず、前提に沿った説明を続けることがあります。
その結果、最初の前提が誤っていても、説明全体が自然で説得力のある文章になり、誤りに気づきにくくなることがあります。
そのため、AIに質問するときは、質問に含まれている前提そのものが正しいかを確認することが重要です。
必要に応じて、「この前提は正しいですか」「前提に誤りがあれば指摘してください」とAIに確認することも有効です。
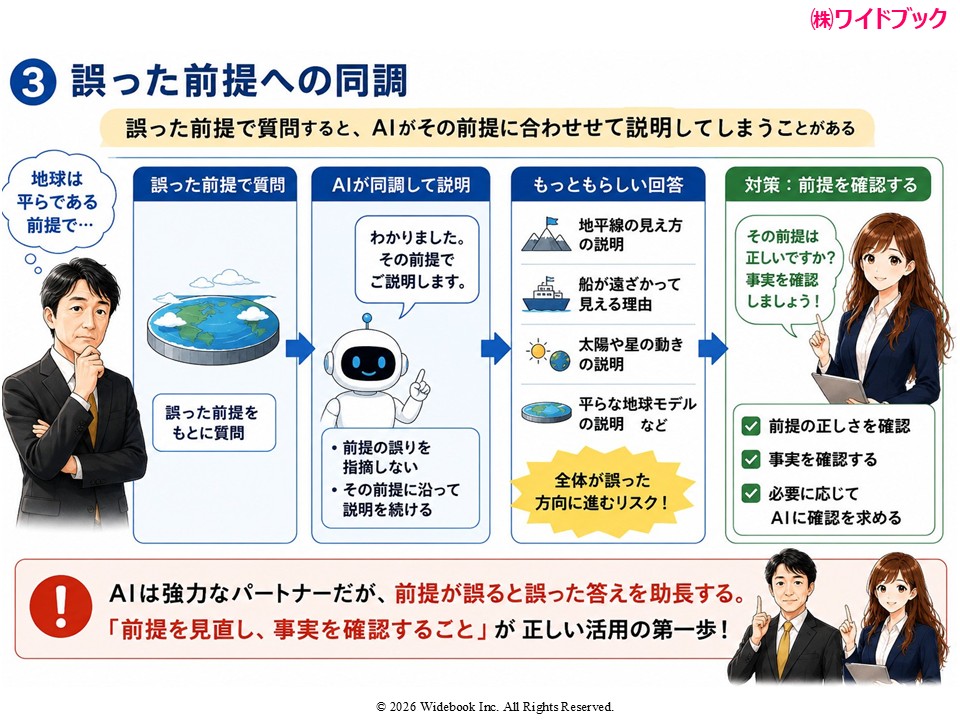
図2-3-4 AIは誤った前提に同調してしまうことがある
④ 文脈の取り違え
会話の途中で話題が変わっているにもかかわらず、過去に出たキーワードやテーマを、現在の回答に不適切に混ぜてしまうことがあります。
生成AIは、それまでの会話の流れを踏まえて回答を作ります。この仕組みによって対話を続けやすくなる一方で、以前の話題を現在の質問にも関係する情報だと捉えてしまう場合があります。
たとえば、最初に「マーケティング戦略」について相談した後、話題を変えて「社内研修の内容」について質問したとします。このとき、話題が変わったことが十分に伝わっていないと、以前のマーケティング戦略の内容が、社内研修の回答に混ざってしまうことがあります。
その結果、文章そのものは自然でも、質問の意図から外れた回答になったり、関係のない情報が含まれたりすることがあります。
そのため、話題を大きく変えるときには、「ここからは別の話題です」などと伝え、新しい目的や前提(背景・事実)を改めて示すことが重要です。
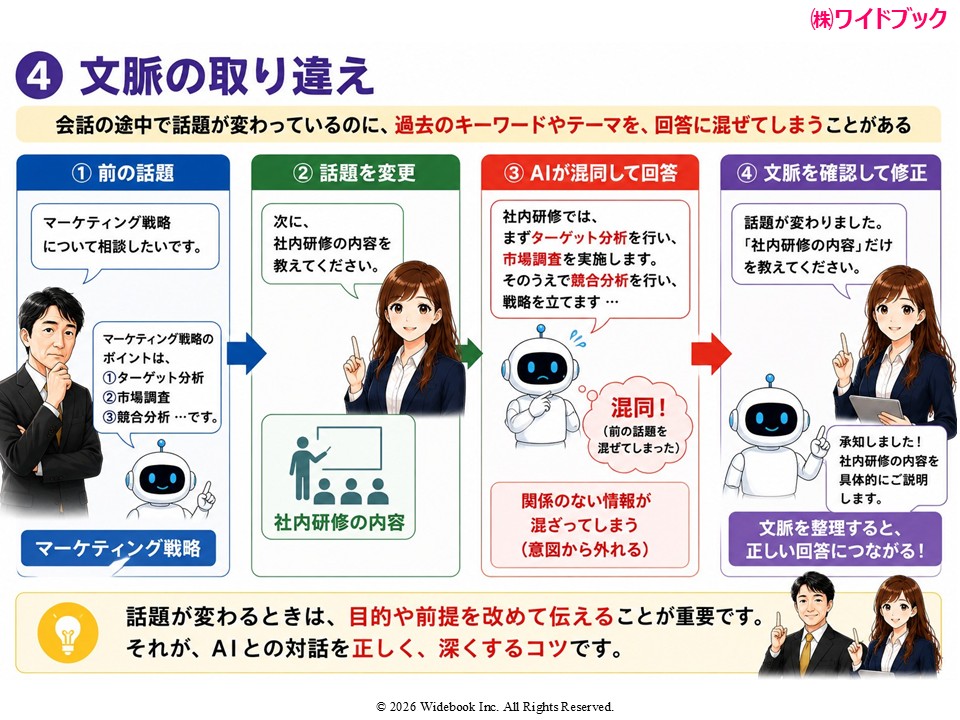
図2-3-5 AIは文脈を取り違え、関係のない情報を混ぜてしまうことがある
本節のまとめ
― AIの回答を「考えるための案」として受け取る ―
生成AIは、自然で説得力のある文章を作ることができますが、その内容が常に正しいとは限りません。
本節では、AIが誤った情報を出す主なパターンとして、ハルシネーション、最新性や時点の取り違え、誤った前提への同調、文脈の取り違えの四つを確認しました。
大切なのは、AIの回答を最初から正しい答えとして受け取るのではなく、「考えるための案」として受け取ることです。
重要な情報については、事実や情報の時点、前提や文脈に誤りがないかを確認する必要があります。
では、生成AIを安全に活用するために、人間は具体的に何を確認すればよいのでしょうか。
次の節では、「AI活用時に確認すべき四つの基本」として整理します。
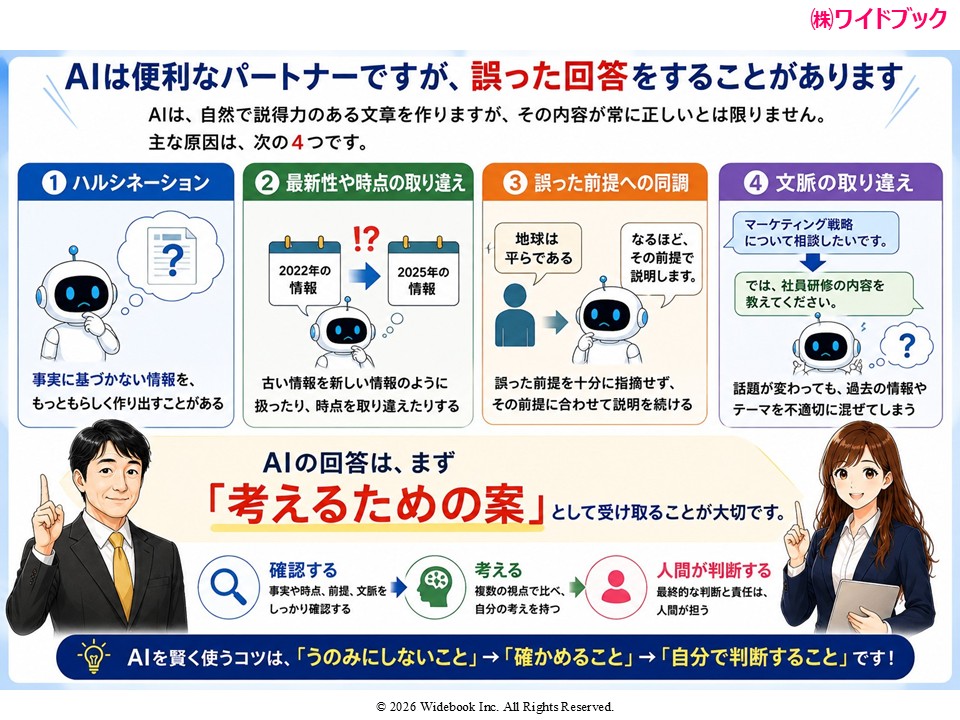
図2-3-6 AIが誤った情報を出す四つのパターン
2-4 AI活用時に確認すべき四つの基本
― 安全に活用するために、人間が確認すべきこと ―
実務で生成AIを活用するときには、便利さだけでなく、誤情報や情報漏えい、権利侵害などのリスクにも注意する必要があります。
前の節で確認したように、生成AIは自然で説得力のある文章を作ることができますが、その内容が常に正しいとは限りません。
また、AIを利用するときには、出力された情報だけでなく、AIにどのような情報を入力するのか、生成された文章や画像をどのように利用するのかについても注意が必要です。
AIは、情報の整理、文章の作成、アイデア出し、判断材料の提示など、さまざまな場面で人間を支援してくれます。
しかし、AIにすべてを任せるのではなく、AIに任せることと、人間が確認・判断することを分けて考えることが重要です。
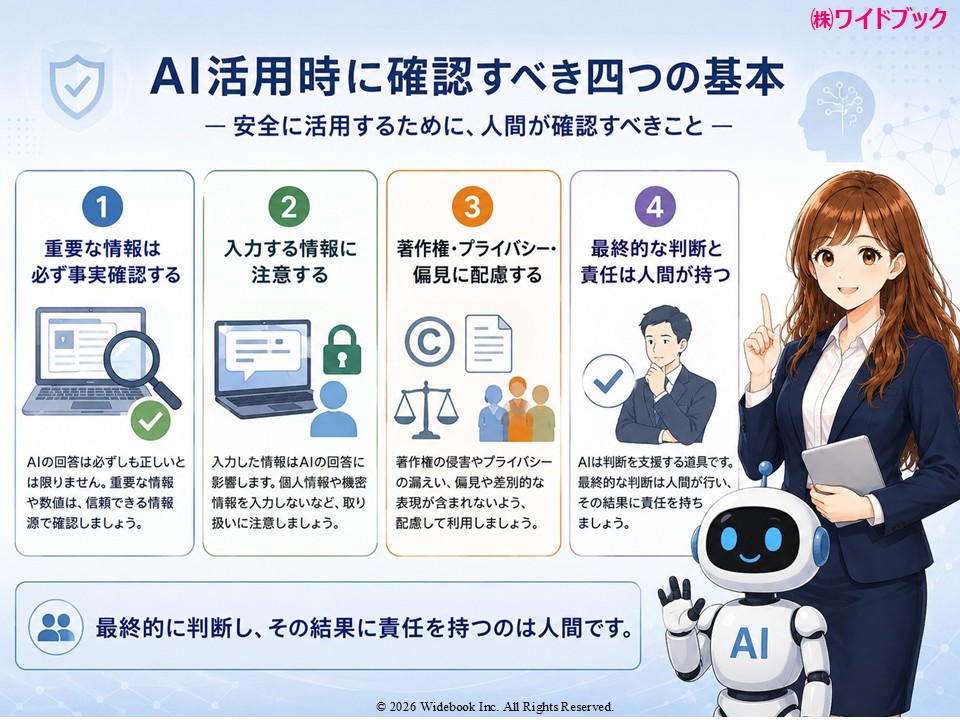
ここでは、生成AIを安全に活用するために、人間が最低限確認しておきたいことを、次の四つの基本に整理します。
(1)重要な情報は必ず事実確認する
生成AIの回答は、自然で説得力のある文章であっても、その内容が事実として正しいとは限りません。そのため、重要な情報については、AIの回答だけで判断せず、人間が事実確認することが必要です。
特に、会社名、人物名、数値、法律、制度、年月日、統計、最新情報などは注意が必要です。
これらの情報は、誤りが含まれていたり、古い情報が現在の情報として示されたりすることがあります。事実確認をするときは、公式サイト、行政機関、企業の公開資料、原典となる文献など、信頼できる一次情報を確認することが基本です。
また、一つの情報だけで判断するのではなく、必要に応じて複数の情報源を照らし合わせることも大切です。
その際には、「その情報の根拠は何か」「いつの時点の情報か」「現在も有効な情報か」という視点で確認します。
特に、契約、法律、経営判断、対外的に公表する資料など、誤りが大きな影響につながる場面では、AIの回答をそのまま使用せず、根拠となる情報を確認したうえで判断することが重要です。
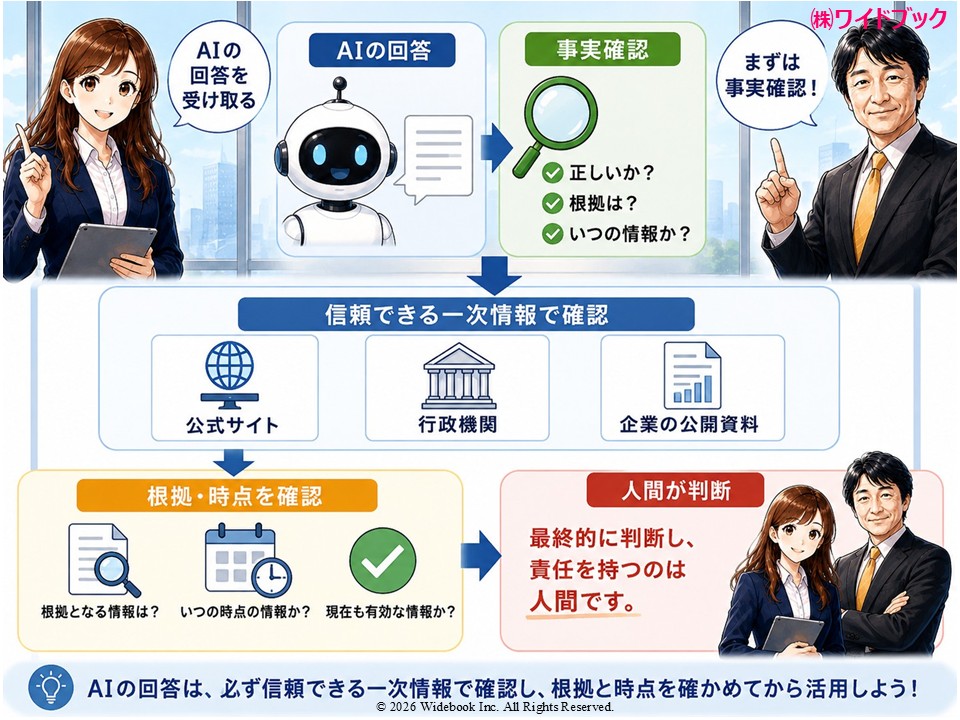
図2-4-1 重要な情報は信頼できる情報源で事実確認する
(2)入力する情報に注意する
生成AIを利用するときには、AIから出てくる情報だけでなく、自分がAIに入力する情報にも注意する必要があります。
生成AIに入力したプロンプトや文章、画像、ファイルなどの情報は、利用するサービスや契約、設定によって、モデルの学習やサービスの改善などに利用される場合があります。一方で、入力した情報をモデルの学習に利用しないサービスや契約、設定もあります。
そのため、生成AIに入力した情報がすべて学習に利用されるわけではありませんが、自分が利用しているサービスで、入力した情報がどのように取り扱われるのかを確認しておくことが重要です。
個人情報、社外秘の情報、顧客情報、契約書、未公開データなどには、外部に知られてはいけない情報や、取り扱いに注意が必要な情報が含まれている場合があります。便利だからといって、そのままAIへ入力することは避けなければなりません。
また、生成AIサービスによって、入力した情報の取り扱い、保存の方法、学習への利用の有無、管理の仕組みなどは異なります。そのため、「AIだから危険」「入力しても大丈夫」と一律に判断するのではなく、利用しているサービスの利用条件や設定を確認することが大切です。
企業や組織で利用する場合には、個人の判断だけで利用するのではなく、組織が定めた情報セキュリティルールや生成AIの利用ルールに従うことが基本です。
AIに情報を入力する前に、「この情報を外部のサービスに入力してよいか」「個人や顧客を特定できる情報が含まれていないか」「社外に出してはいけない情報ではないか」を確認する習慣を持つことが重要です。
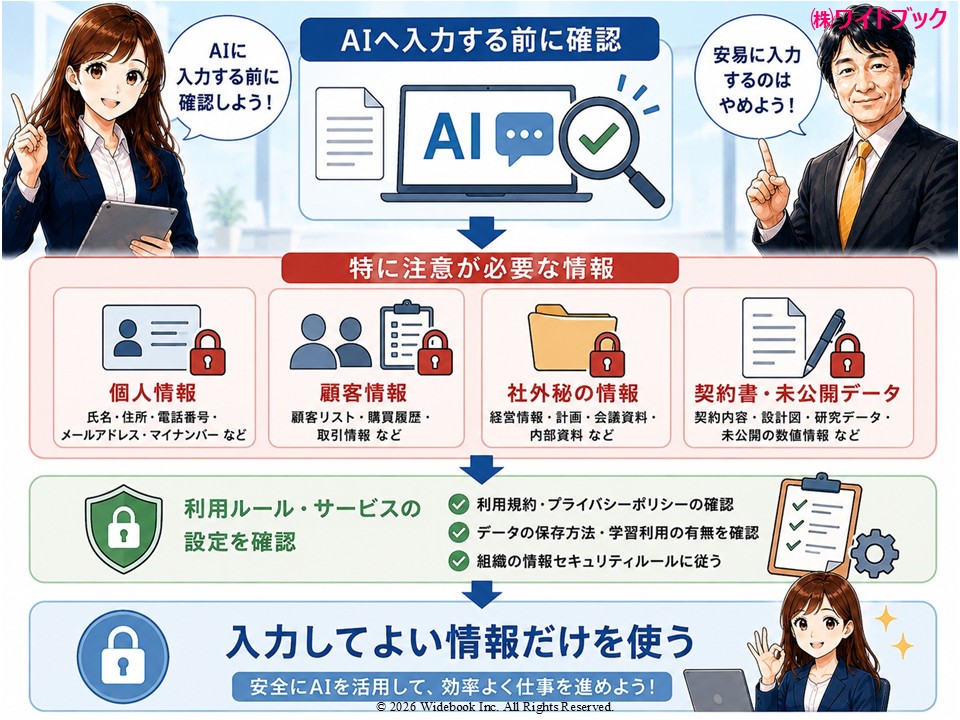
図2-4-2 AIに入力する情報を事前に確認する
(3)著作権・プライバシー・偏見に配慮する
生成AIは、文章、画像、音声など、さまざまなコンテンツを作ることができます。しかし、AIが生成したものであれば、そのまま自由に利用してよいとは限りません。
生成AIのモデルは、インターネット上で公開されている情報など、大量のデータを使って学習・開発されています。
その中には、著作権で保護された文章や画像などが含まれる場合があります。なお、学習に使われるデータの種類や収集方法は、生成AIのサービスやモデルによって異なります。
また、AIが学習に利用していることと、AIが生成した内容を利用者が自由に利用・公開できることは別の問題です。
AIが作った文章や画像などを利用するときには、他者の著作物と同一または類似した表現が含まれていないかなど、著作権に配慮する必要があります。特に、生成した内容をWebサイトや広告、教材、出版物などで公開・利用する場合には注意が必要です。
また、実在する人物の氏名や写真、個人に関する情報などを扱う場合には、肖像権やプライバシーにも配慮する必要があります。本人の許可なく利用・公開してよい情報なのかを確認することが大切です。
さらに、生成AIの回答には、学習したデータなどの影響によって、特定の人や集団に対する偏見や差別的な表現が含まれる可能性があります。文章として自然に見えても、特定の立場に偏っていないか、誰かを不当に傷つける表現になっていないかを確認する必要があります。
AIが生成した内容を利用するときには、「AIが作ったから大丈夫」と考えるのではなく、最終的に利用・公開する人が内容を確認することが重要です。
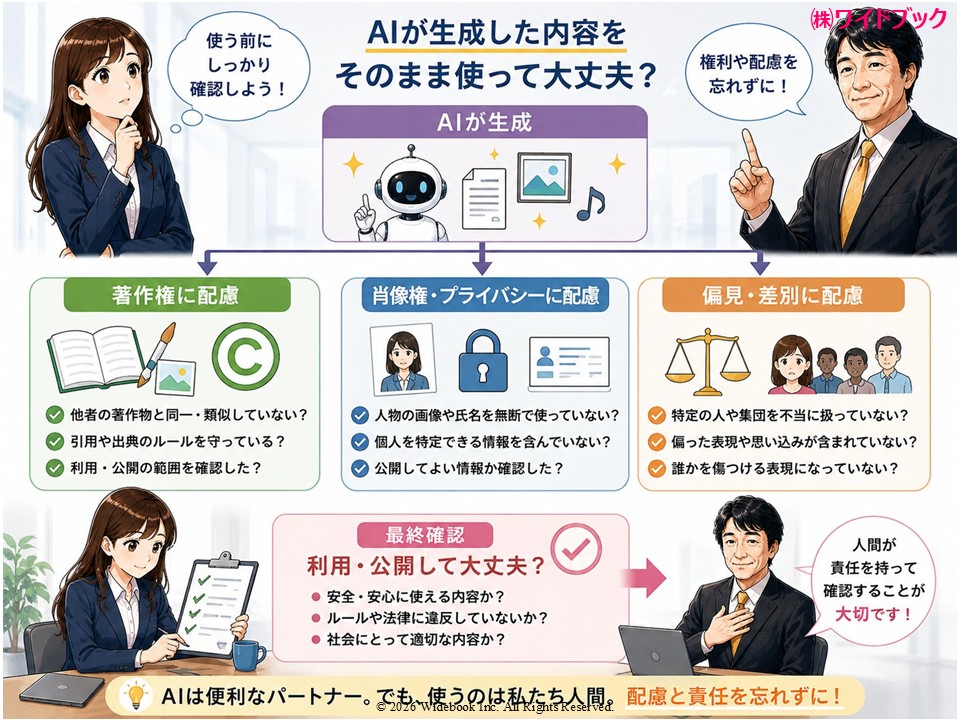
図2-4-3 AIが生成した内容は権利・プライバシー・偏見を確認する
(4)最終的な判断と責任は人間が持つ
生成AIは、情報を整理したり、複数の選択肢を示したり、判断に必要な材料をまとめたりすることができます。
しかし、AIは人間に代わって、すべての状況を理解し、最終的な判断を行うものではありません。
仕事や学習の場面では、AIが示した回答や提案を参考にしながら、目的や状況に合っているか、根拠は十分か、どのような影響があるかを人間が確認する必要があります。
たとえば、AIが複数の案を示した場合でも、どの案を採用するのかを決めるのは人間です。また、その案を実行することで、顧客、組織、社会などにどのような影響が生じるのかについても考える必要があります。
大切なのは、AIに判断そのものを任せるのではなく、AIを「考えるための支援ツール」として活用することです。
AIに任せられる部分は任せ、人間が確認すべき部分は確認し、そのうえで意思決定を行います。
AIがどれほど高度になっても、最終的に何を選び、どのように行動するかを判断し、その結果に責任を持つのは人間です。
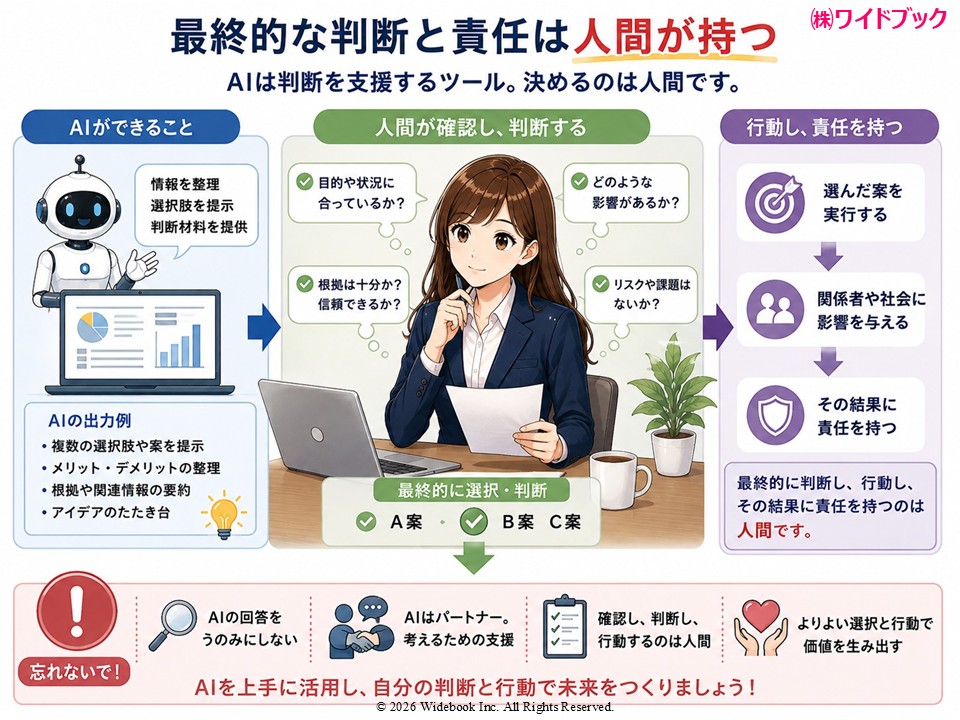
図2-4-4 AIを活用し、最終的に判断するのは人間
本節のまとめ
― AIを安全に活用するために ―
生成AIを安全に活用するためには、AIの便利さだけでなく、その特徴や限界を理解したうえで利用することが大切です。
本節では、「重要な情報を事実確認する」「入力する情報に注意する」「著作権・プライバシー・偏見に配慮する」「最終的な判断と責任は人間が持つ」という四つの基本を確認しました。
AIは、情報を整理し、アイデアを出し、複数の選択肢を示すなど、人間の思考や判断を支援することができます。
しかし、AIの回答をそのまま受け入れるのではなく、人間が確認し、考え、判断したうえで活用することが重要です。
生成AIは、人間に代わって判断する存在ではなく、人間の思考や創造を支援するパートナーとして活用することが大切です。
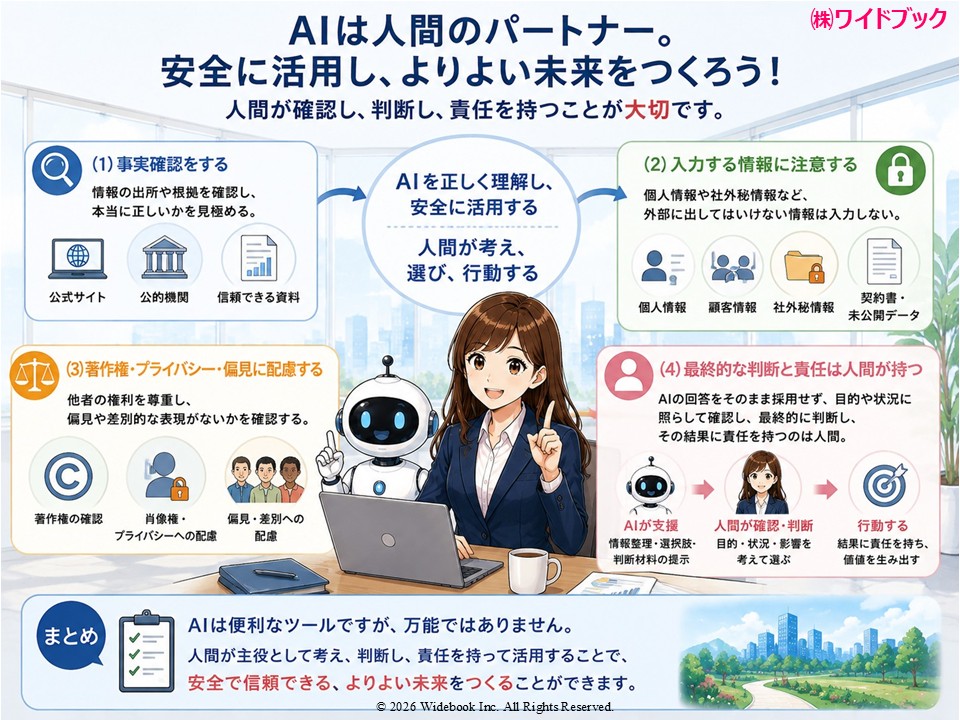
図2-4-5 AIを安全に活用するための四つの基本
第2部のまとめ
― AIの仕組みと限界を理解し、対話へつなげる ―
第2部では、AIの発展の歴史から、現在の生成AIを支えるTransformerの基本的な仕組みとして、その中心となるSelf-Attentionの流れ、そして生成AIが誤った情報を出す理由について学びました。
生成AIは、文章の意味を人間と同じように理解し、事実を一つひとつ確認して答えているわけではありません。言葉どうしの関係を捉え、文脈に合う可能性の高い言葉を予測しながら文章を作っています。
そのため、自然で説得力のある回答であっても、ハルシネーション、最新性や時点の取り違え、誤った前提への同調、文脈の取り違えなどが起こることがあります。
また、生成AIを安全に活用するためには、重要な情報を事実確認すること、入力する情報に注意すること、著作権・プライバシー・偏見に配慮すること、そして最終的な判断と責任は人間が持つことが重要です。
大切なのは、AIを過信することでも、間違えるから使わないことでもありません。
AIの仕組みと特徴、そして限界を理解したうえで、人間が主体的に考え、確認し、判断しながら活用することです。
次の第3部では、この理解を土台として、AIに答えを求めるだけではなく、AIとの対話を通じて、自分の考えを整理し、問い直し、深めていく方法を学びます。
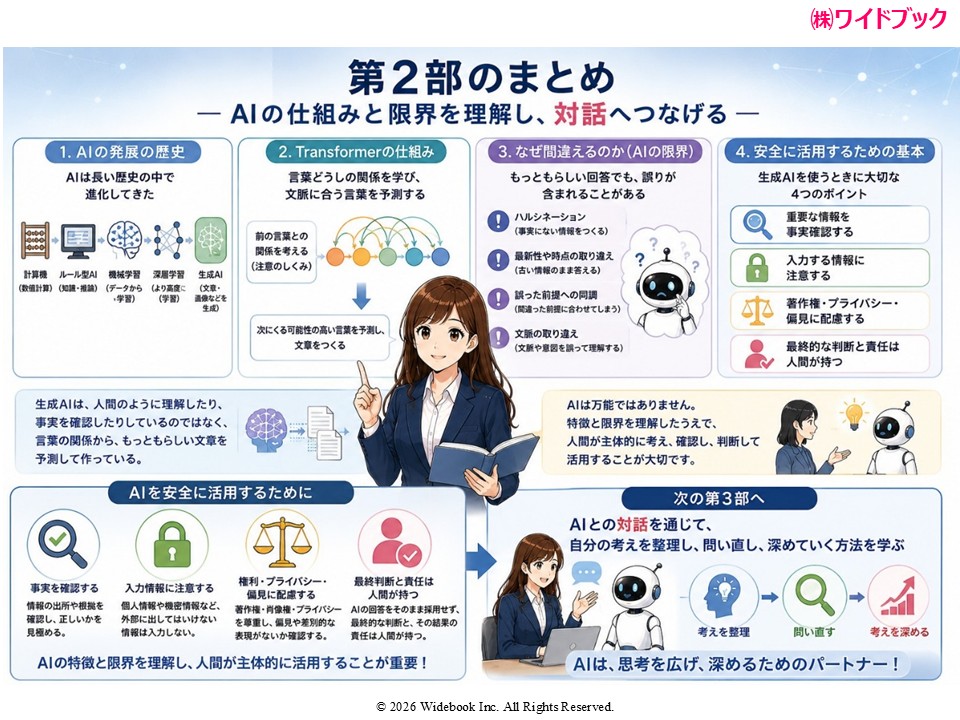
図2-5-1 第2部のまとめ ― AIの仕組みと限界を理解し、対話へつなげる ―